余昌黔

余昌黔

可灵AI · 图像模型中心负责人

打造能感知、会推理、善创造的新一代视觉基础模型。

我在可灵AI负责 图像模型中心,统筹视觉生成、编辑与多模态理解基座模型的研发与落地。从定义实时视觉经典架构(BiSeNet、Lite-HRNet)到打造全球第一梯队多模态生成系统(Kling Image 4.0、SkyReels),致力于将原创架构研究转化为亿级用户产品。华中科技大学博士,获 CSIG 全国优博 与中国电子学会自然科学二等奖。
经历
可灵AI 2026.04 – Present
算法总监

作为 图像模型中心负责人,统筹可灵AI图像基座模型体系的研发与落地(含位列 Artificial Analysis 全球第 6、国内第 1 的原生 8K 基座 Kling Image 4.0)。当前重点方向:理解生成一体化。

技术主管

带领 Kling-Image-Omni 团队,构建大规模视觉生成与理解产品。核心交付包括 Kling-Image-O1——将视觉推理引入图像生成,以及 Kling-Image 3.0 & 3.0 Omni,可灵AI最新一代图像基础模型。
昆仑万维(天工) 2023 – 2025

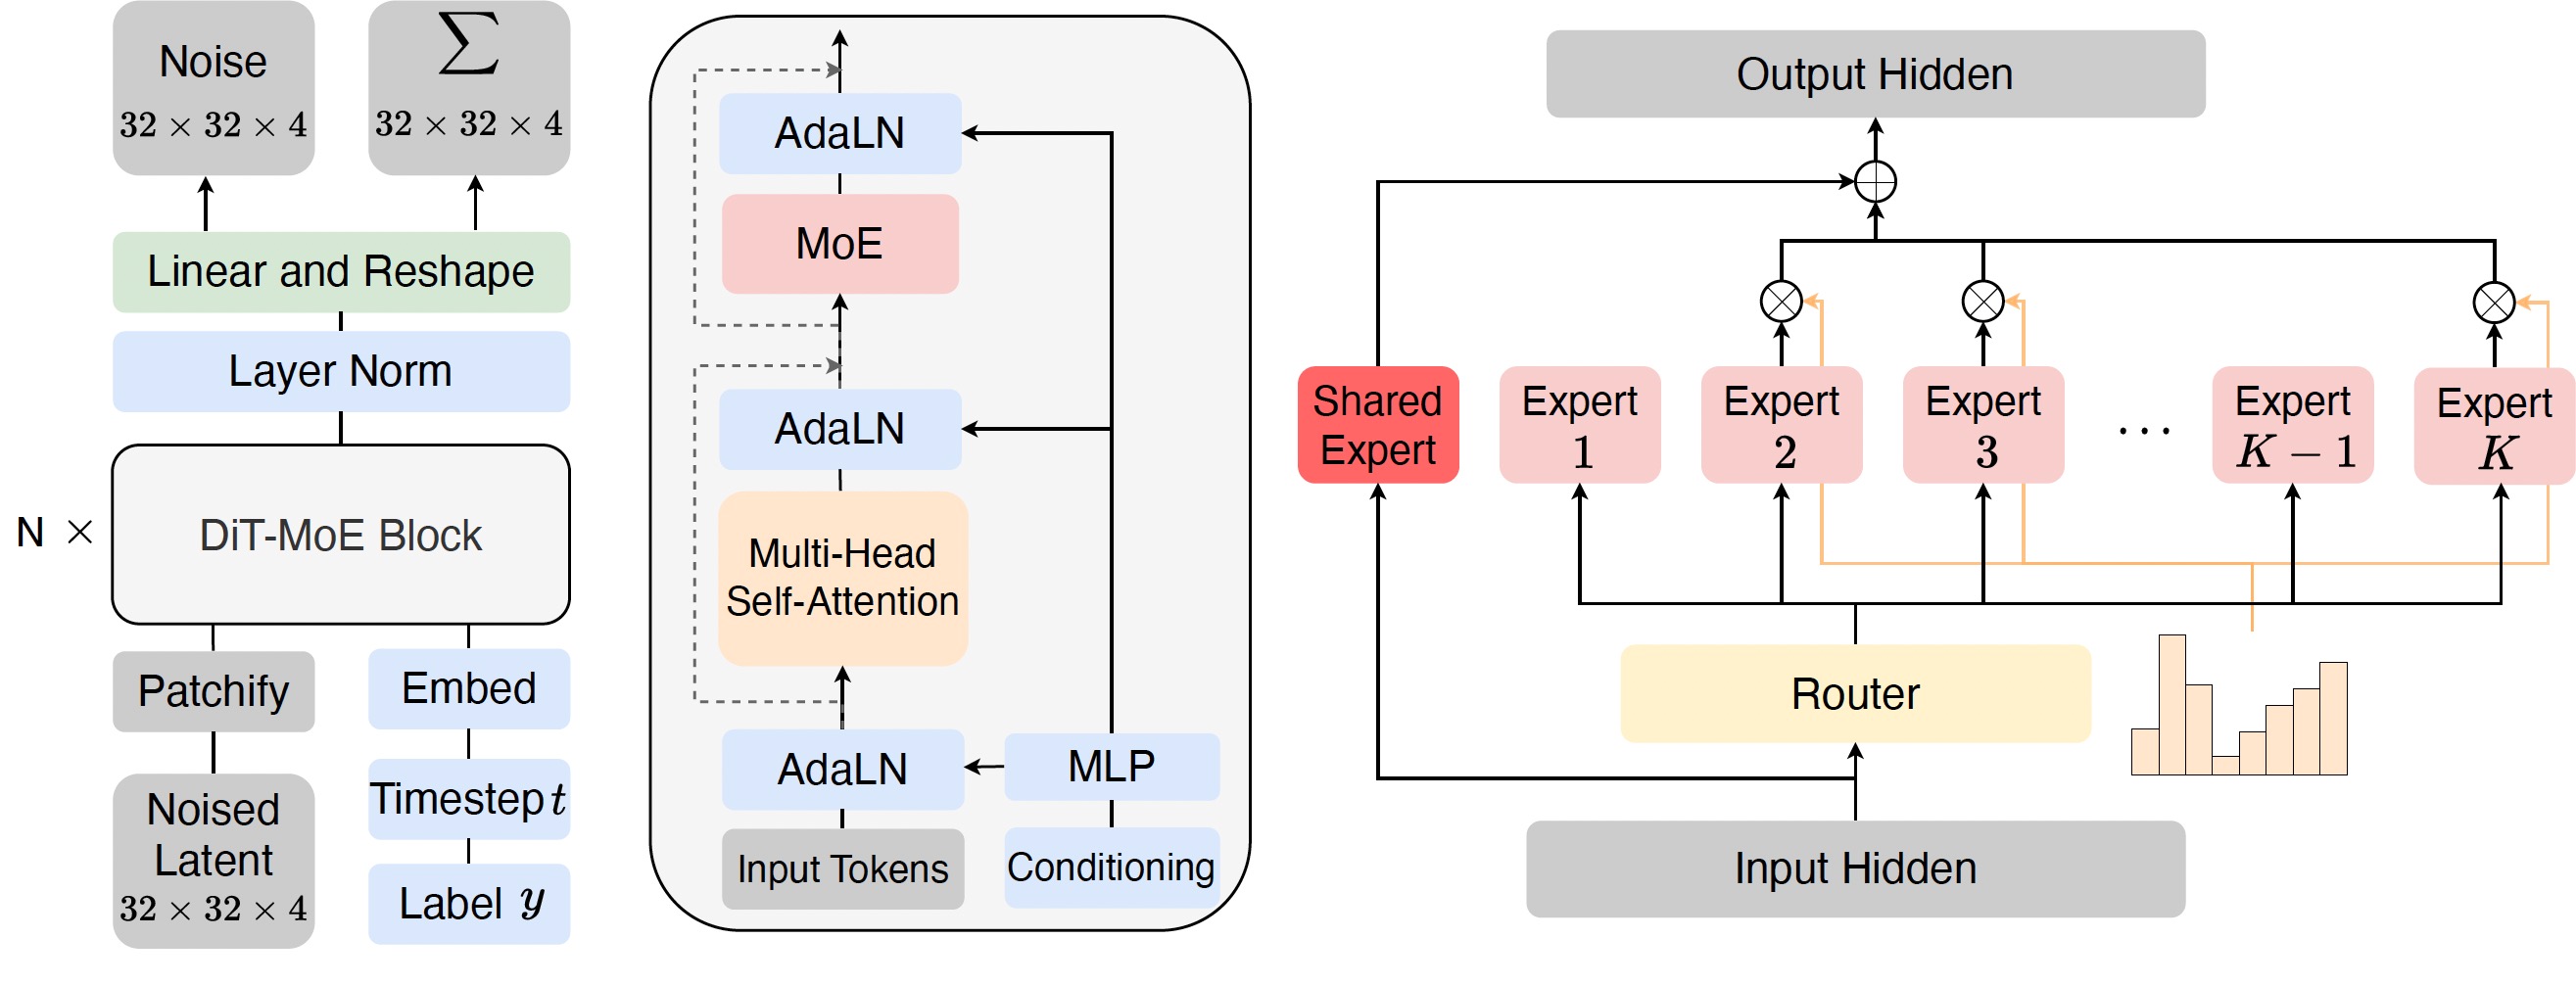
主导多模态 AI 研究。交付了 Skywork-VL-32B 视觉语言模型,以及 SkyReels 中的分镜生成大模型,驱动影视级镜头规划。同时构建了可扩展的 Diffusion(MoE)训练流水线,支持文生图。
美团 2021 – 2023

自动配送部研究科学家,为自动配送车队开发轨迹预测和运动规划模型。提出的基于 Transformer 的预测模型部署在真实配送车上,服务百万级订单。

华中科技大学 2016 – 2021
博士研究生

研究方向为语义分割与全景分割。在 ECCV 2018 的 COCO & Mapillary 全景分割挑战赛中获得第一名。创建了 TorchSeg(1,400+ GitHub star)。
代表模型 从实时视觉感知到多模态生成基座

Kling Image 4.0

预览版 · 2026.11
新一代图像生成与编辑基座 · 可灵AI

新一代原生 8K 图像基座模型,融合超高清高保真文生图与指令级图像编辑能力。首次亮相即在 Artificial Analysis 国际评测双榜位列全球第 6、国内第 1,较 3.0 Omni 在文生图与图像编辑分别跃升 +255 Elo 与 +228 Elo。

  • 原生 8K 超高清直出
  • 长上下文多参考一致
  • 精准图文与版式
  • 指令级图像编辑
全能图像基座 · 可灵AI

大规模落地的全能图像基座模型,原生支持多参考图合成、主体一致性保持与精细可控编辑。

Kling-Image-O1 推理驱动生成
视觉推理生成 · 可灵AI

将结构化思维链(CoT)推理引入图像生成,突破复杂多约束场景的意图理解与视觉创作。

视频基座与影视分镜 · 昆仑天工

开源以人为中心的视频基座模型,涵盖影视级分镜规划大模型与高表现力肖像动画生成。

Skywork-VL-32B

32B 多模态
视觉语言大模型 · 昆仑天工

大规模视觉语言基座模型,深度融合高分辨率视觉编码器与大语言模型的多模态理解与推理能力。

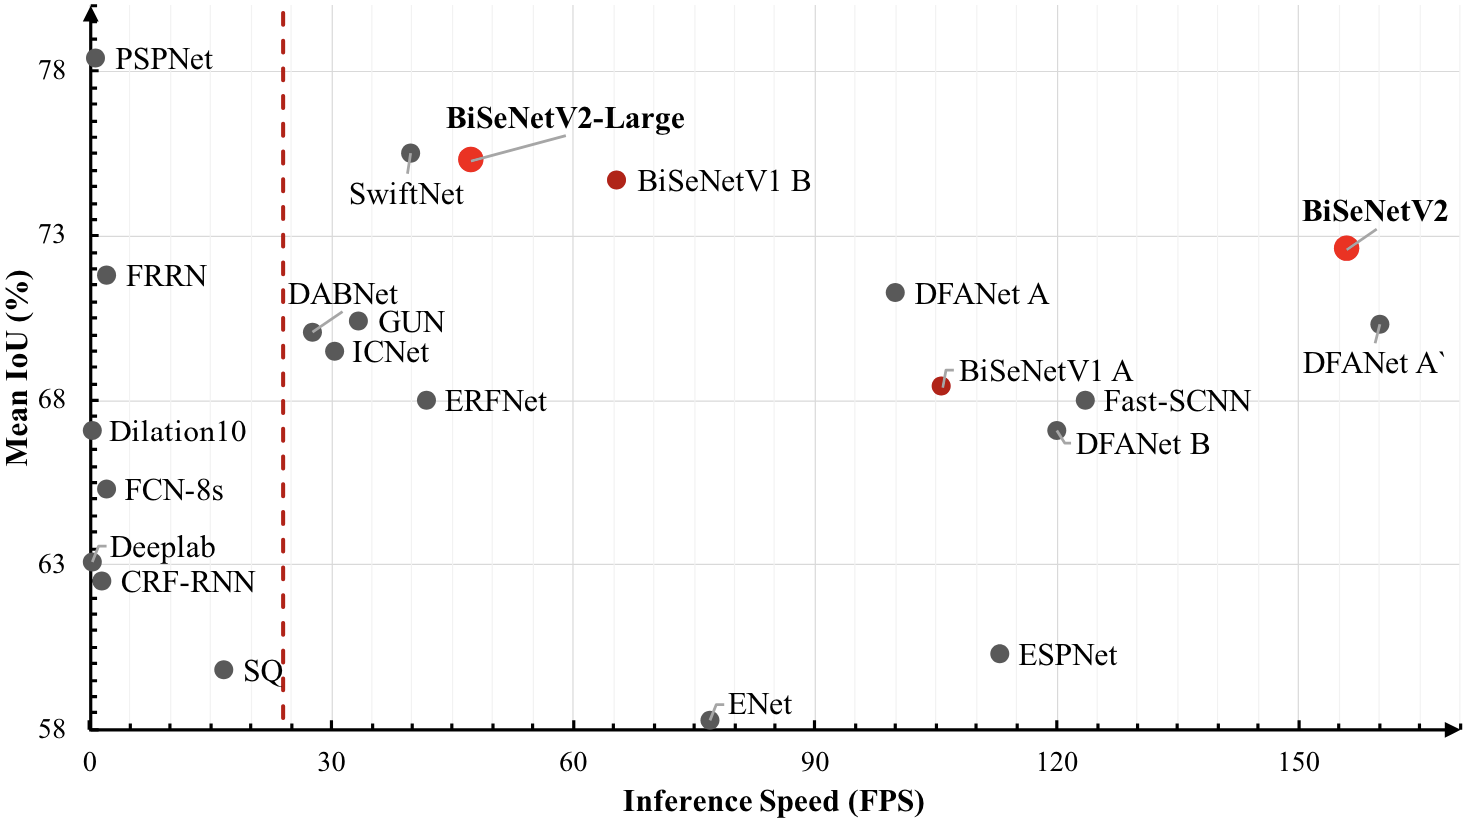
BiSeNet V1 & V2 6,450+ 引用
实时语义分割标杆 · ECCV & IJCV

学界与工业界广泛采用的实时双边语义分割经典架构;获评 ECCV 十大最具影响力论文与 ESI 高被引论文。

Lite-HRNet 800+ 引用 · 920+ ⭐
轻量级高分辨率网络 · CVPR & 微软亚研院

提出条件通道加权的高效高分辨率视觉表征骨干,广泛应用于姿态估计与密集预测。

代表论文 查看全部 →
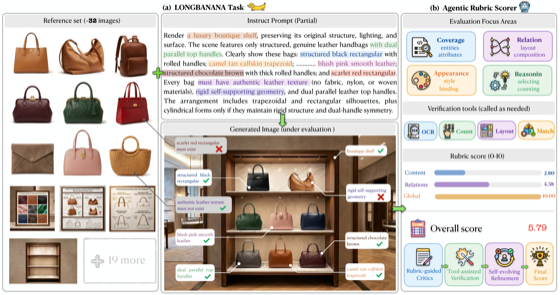
LongBanana: An Expert-Verified Benchmark for Long-Context Multi-Reference Image Synthesis
Haoxiang Cao, Yuxuan Zhang, Penghui Du, Bo Li, Jiajiong Cao, Yingying Fan, Zimeng Wu, Yifu Luo, Mingzhe Zheng, Junwen Miao, Huaisong Zhang, Yang Yao, Yu Wang, Dongfu Jiang, Ping Nie, Wenhu Chen, Chaoqun Wang, Changqian Yu, Kelsey R. Allen
NeurIPS arXiv 主页
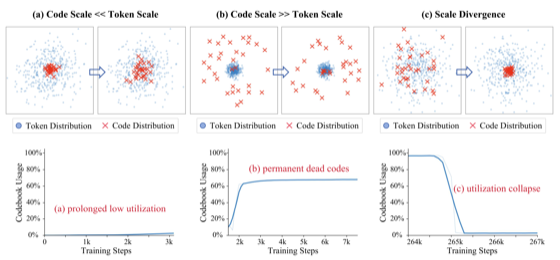
StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
Bao Tang, Jiahao Guo, Haoxiang Cao, Wenyu Liu, Changqian Yu, Kun Gai, Xinggang Wang
NeurIPS 1 引用 arXiv 主页
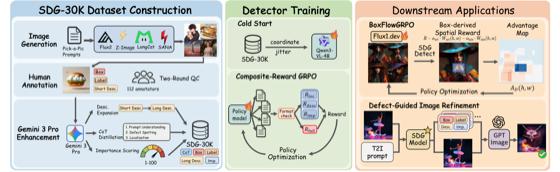
Where, What, Why, and Importance: Structured Defect Grounding for Text-to-Image Feedback
Huaisong Zhang, Hao Yu, Yuxuan Zhang, Jiahe Wang, Xinrui Chen, Haoxiang Cao, Feng Lu, Wendong Zhang, Changqian Yu, Chun Yuan
NeurIPS 4 引用 arXiv
Scaling Diffusion Transformers to 16 Billion Parameters
Zhengcong Fei, Mingyuan Fan, Changqian Yu, Debang Li, Junshi Huang
arXiv 73 引用 arXiv 代码
BiSeNet V2: Bilateral Network with Guided Aggregation for Real-time Semantic Segmentation
Changqian Yu, Changxin Gao†, Jingbo Wang, Gang Yu, Chunhua Shen, Nong Sang
IJCV ESI Highly Cited Paper 2317 引用 论文 arXiv 代码
BiSeNet: Bilateral Segmentation Network for Real-time Semantic Segmentation
Changqian Yu*, Jingbo Wang*, Chao Peng, Changxin Gao†, Gang Yu, Nong Sang
ECCV ECCV 2018 Top-10 Influential Papers 4142 引用 论文 arXiv 代码
开源项目
  • 以人为中心的视频基座模型。2.7k ⭐
  • 基于视频 Diffusion Transformer 的表情肖像动画生成。500+ ⭐
  • 轻量级高分辨率网络。900+ ⭐
  • PyTorch 语义分割代码库 — BiSeNet、DFN、DenseASPP 等。1.4k ⭐
技术愿景与团队招募 可灵图像 · 北京

在 可灵图像(Kling Image),我们相信下一代视觉智能的范式跃迁来自感知、推理与生成的深度统一——构建不仅能渲染高保真像素,更能理解物理规律并在视觉世界中推理与行动的基础模型。

01

理解生成一体化

在统一多模态架构中协同自回归推理与扩散/流匹配生成,让深层语义理解反哺复杂受控创作。

02

视觉分词器与表征学习

探索高压缩率、强语义对齐的新一代视觉 Tokenizer(稀疏专家路由与稳定量化),打通重建保真与生成扩展上限。

03

视觉智能体与推理后训练

推进结构化奖励强化学习(RL)与自进化后训练,赋予模型多步规划、缺陷定位与自主迭代修正的智能体能力。

04

多模态数据与大规模基建

构建高审美、知识密集型多模态数据引擎,研发超大规模稀疏 MoE 训练与极致低延迟推理基建。